

検索エンジンにキーワードを入力してリンクをクリックする——この当たり前だった行動は、今やAIに問いかけてその場で答えを得るスタイルへと完全にシフトしています。2026年の現在、企業のマーケティング戦略を左右するのは「検索順位」ではなく、AIがあなたの企業を「信頼できる情報源」として推奨するかどうかです。このパラダイムシフトの中で、新たに企業の命運を握る概念が「LLMO(大規模言語モデル最適化)」です。
LLMOとは、ChatGPTやGemini、GoogleのAI Overviewsといった生成AIの回答において、自社の情報が正確に参照され、肯定的に推奨されるようにWebサイトを最適化する戦略を指します。従来のSEOが「検索順位の競争」だったのに対し、LLMOは「AIによる推奨(メンション)の獲得」を目指すものです。Ahrefsの調査によれば、検索1位のサイトであってもクリック率は60%以上低下し、ユーザーが検索結果から一歩も出ずに問題を解決する「ゼロクリック検索」が常態化しています。
しかし、これはWebサイトの価値が失われたことを意味しません。むしろ企業は自社サイトを「AIエコシステムへの知識供給源」として再定義する必要があります。AIは無から情報を生み出しているわけではなく、Web上の信頼できるソースを基に回答を生成しているのです。つまり、AIにとって「最も信頼できる、引用するに値するデータソース」としての地位を確立すること——これが2026年のLLMO対策の本質なのです。本記事では、なぜLLMO対策がSEO以上に重要になったのか、その理由から具体的な9つの施策、業界別のアプローチ、効果測定の新基準まで、生成AI時代に「選ばれ続ける企業」になるための戦略をすべて解説します。
目次
- LLMO(大規模言語モデル最適化)の定義と2026年現在の重要性
- LLMOの定義と従来のSEOとの違い
- 従来のSEOの限界とゼロクリック検索の常態化
- Webサイトのナレッジ・プロバイダーへの再定義
- AI時代における信頼のインフラとしてのLLMO
- LLMOと従来のSEOの決定的な違いと共通点
- ターゲットの違い
- 評価指標の違い
- 共通点:E-E-A-Tの重要性
- キーワードからエンティティへの移行
- ハイブリッド戦略の必要性
- AIが情報を取得・評価する「RAG」と「事前学習」の仕組み
- 事前学習とRAGの基本的な違い
- AIがRAGで情報を評価する4つのステップ
- マーケターが見落としやすいAIの情報評価の本質
- 2026年のLLMO対策に必要な二層構造の戦略
- 【コンテンツ編】AIに選ばれるための具体的対策5選
- 対策1:結論ファーストの「逆ピラミッド構造」
- 対策2:独自調査データと「一次情報」の言語化
- 対策3:FAQ(質問と回答)形式の導入
- 対策4:客観的・フォーマルな文体(Wikipediaスタイル)
- 対策5:統計・数値データの適切な配置
- 【テクニカル編】AIクローラーに優遇される技術的対策4選
- 対策1:JSON-LDによる構造化データの実装
- 対策2:robots.txtによるクローラー最適化
- 対策3:JavaScript依存からの脱却(HTMLへの直書き)
- 対策4:「llms.txt」の試験的導入
- E-E-A-Tの強化がLLMOの成否を分ける理由
- LLMOにおけるE-E-A-T強化の3つの不可欠な要素
- E-E-A-T強化のための実務的な施策
- E-E-A-T強化が長期的なLLMO対策の基盤である理由
- 言及(メンション)を獲得するための外部施策とPR戦略
- デジタルPRの強化とニュースサイトでの言及
- 比較・レビューサイトでの露出戦略
- Wikipediaの整備と情報提供
- メディアリレーションの構築
- 業界データの先行提供
- SNSでの発信と権威性構築
- クリニックやBtoB企業が取り組むべき業界別LLMOのポイント
- 医療機関における広告ガイドラインとAI対策の両立
- BtoB企業における比較文脈での露出戦略
- 士業における専門性の透明化
- 既存活動とLLMO対策のシームレスな統合
- LLMOの効果測定とKPI設定の新しい基準
- 従来のSEOとLLMO時代における指標の違い
- AI回答内での自社言及の検出
- 指名検索数の推移による測定
- AI経由の流入計測
- LLMO施策の真の効果を測定する課題と対策
- その他の重要な指標
- LLMO効果スコアの統合と中長期的な計測体制の構築
- LLMO対策における注意点とよくある誤解
- キーワード詰め込みの落とし穴
- 技術的対応だけでは不十分
- 新規記事の大量作成より既存ページの強化
- 誤情報・ハルシネーション対策の必要性
- AI最適化とユーザー体験のバランス
- SEOへの投資を継続すること
- 長期的な視点での効果測定
- まとめ:生成AI時代に「選ばれ続ける」ためのWeb戦略
- 2027年、2028年への企業の進むべき道
- 今、企業が準備すべきこと
LLMO(大規模言語モデル最適化)の定義と2026年現在の重要性
2026年11月現在、Webマーケティングの風景は劇的な変化を遂げました。数年前まで主流だった「検索エンジンにキーワードを入力し、表示されたリンクをクリックする」という行動は、今や「生成AIに問いかけ、その場で回答を得る」というスタイルへと完全にシフトしています。このパラダイムシフトの中で、企業の命運を握る新たな概念が「LLMO(Large Language Model Optimization:大規模言語モデル最適化)」です。
LLMOの定義と従来のSEOとの違い
LLMOとは、ChatGPTやClaude、Gemini、そしてGoogleのAI Overviews(AIO)といった大規模言語モデル(LLM)の回答において、自社の情報が正確に参照され、かつ肯定的に推奨されるようWebサイトや外部情報を最適化する戦略を指します。かつてのSEOが「検索順位の競争」であったのに対し、LLMOは「AIによる推奨(メンション)の獲得」を目指すものです。
従来のSEOの限界とゼロクリック検索の常態化
なぜ今、LLMO対策がこれほどまでに重要視されているのでしょうか。その最大の理由は、従来のSEOの限界にあります。
Ahrefsの2026年の調査によれば、AI概要が表示される情報収集型キーワードにおいて、検索1位のサイトであってもクリック率はかつての水準から60%以上低下するというデータが出ています。いわゆる「ゼロクリック検索」が常態化し、ユーザーが検索結果画面から一歩も出ずに解決策を得るようになった結果、「順位は高いのに流入が減る」という現象が各社で相次いでいます。この矛盾した状況は、従来のSEO指標だけではマーケティング戦略を立案できなくなったことを意味しています。
Webサイトのナレッジ・プロバイダーへの再定義
しかし、これは決してWebサイトの価値が失われたことを意味しません。むしろ、企業は自社サイトを「AIエコシステムへの知識供給源(ナレッジ・プロバイダー)」と再定義する必要があります。AIは無から情報を生み出しているわけではなく、Web上の信頼できるソースを元に回答を生成しています。つまり、AIにとって「最も信頼できる、引用するに値するデータソース」としての地位を確立することこそが、2026年のLLMO対策の本質なのです。
AIの回答内で「〇〇社の調査によれば」「〇〇という製品が推奨されます」と言及されることは、直接のクリックを超えた強力なブランド認知と信頼を生みます。ユーザーはAIの回答で解決しなかった深い悩みが生じた際、あるいは購買の最終決定を下す際、AIが信頼したそのブランドを指名して検索します。
AI時代における信頼のインフラとしてのLLMO
LLMOは、単なる流入獲得手段ではなく、AI時代における「信頼のインフラ」を構築するための投資なのです。従来のSEOが「道案内(リンク)」を作る作業であったとするなら、LLMOはAIという新しい世界観の中で「自社の知識が選ばれ、活用される状態」を作る戦略に他なりません。今後のマーケティング成功の鍵は、検索順位だけでなく、AIにいかに認識され、信頼されるかという新たな評価軸を手に入れることにあります。
LLMOと従来のSEOの決定的な違いと共通点
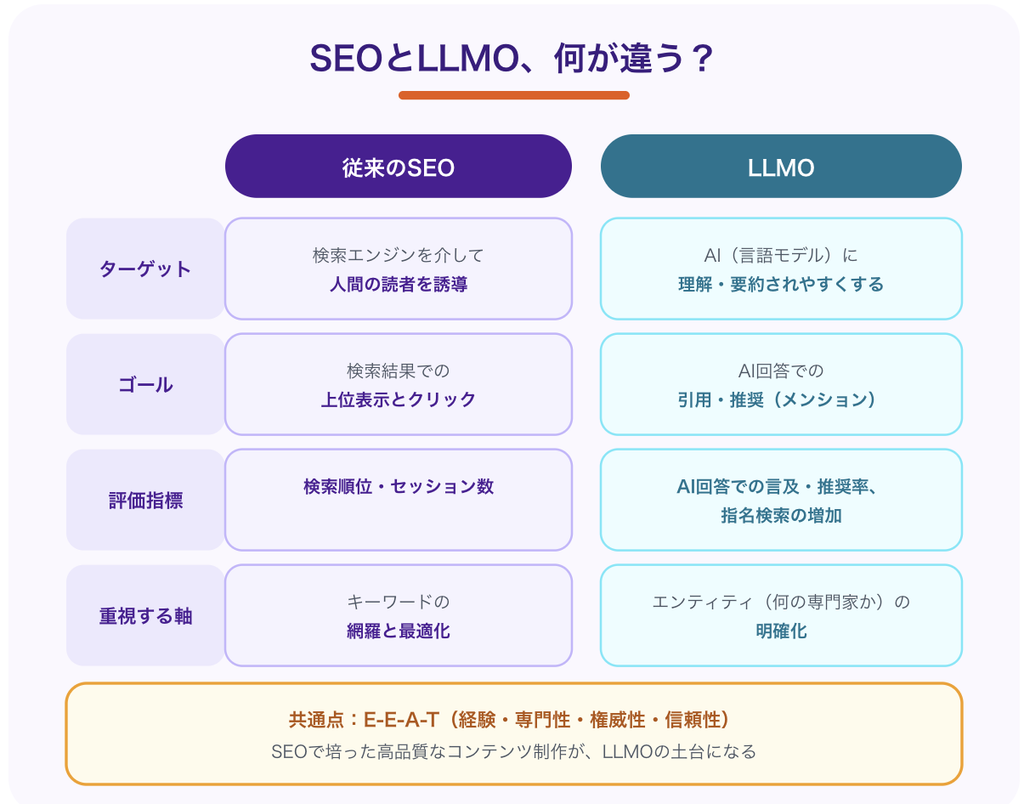
LLMO(大規模言語モデル最適化)と従来のSEO(検索エンジン最適化)は、しばしば対立するものとして語られますが、実務的には「地続きの進化」であると捉えるのが正解です。しかし、評価のメカニズムや目指すべきゴールには、明確な違いが存在します。
ターゲットの違い
最大の違いは「ターゲット」です。
従来のSEOは、Googleの検索アルゴリズムを介して「人間の読者」をサイトへ誘導することを目指します。そのため、検索意図の網羅性やクリックを誘発するタイトル付けが重視されました。ユーザーが検索結果をスキャンして「このページが欲しい情報を持っていそうだ」と判断するまでの体験が、SEOの評価対象だったのです。一方、LLMOのターゲットは「AI(言語モデル)」です。AIがいかに情報を理解しやすく、要約しやすいか、そして信頼に足る情報源として認識するかという「機械に対する解釈性」が問われます。AIはテキストをクリックして読むのではなく、パラメータとして分解し、統計的に処理しているため、ユーザーフレンドリーな表現よりも、構造的な明確さが重視されるのです。
評価指標の違い
評価指標(KPI)も大きく異なります。SEOでは「検索順位」や「セッション数」が絶対的な指標でしたが、LLMOでは「AI回答内でのブランド推奨率(シェア・オブ・ボイス)」や「引用の有無」、そしてその結果としての「指名検索数の増加」が重視されます。
AIの回答によってユーザーの悩みがある程度解決してしまう以上、サイトへの流入数だけで施策の成否を判断するのは2026年においてはナンセンスと言えるでしょう。むしろ、AIが自社を「信頼できる情報源」として言及してくれているかどうか、その言及がユーザーのブランド認知や指名検索につながっているかを測定することが、新たな評価の中心になります。
共通点:E-E-A-Tの重要性
しかし、両者には強力な共通点もあります。それは「E-E-A-T(経験・専門性・権威性・信頼性)」の重要性です。AIは、情報の信頼性を判断する際に、ドメインの権威性や著者の専門性を極めて重視します。実際、検索順位が高いサイトはAIにも引用されやすいという相関関係は依然として強く、SEOで培ってきた「高品質なコンテンツ制作」のノウハウは、LLMOの土台として不可欠です。つまり、SEOがLLMOの前提条件となっているのです。
キーワードからエンティティへの移行
実務上の大きな変化としては、「キーワード」から「エンティティ(実体)」への移行が挙げられます。SEOでは特定のキーワードを含めることが重視されましたが、LLMOでは「その企業が何について詳しい専門家なのか」という属性や関係性の定義が重要になります。例えば、「LLMO 対策」というキーワードで記事を書く場合、単に言葉を散りばめるのではなく、「自社がLLMO対策の最新データを持つ専門機関である」という事実をAIに認識させることが、LLMOにおける勝利条件となるのです。
ハイブリッド戦略の必要性
従来のSEOが「道案内(リンク)」を作る作業であったとすれば、LLMOは「AIの知識ベースの一部」になる作業だと言えるでしょう。この違いを理解した上で、SEOで流入の土台を作り、LLMOでAIによる推奨を獲得するというハイブリッド戦略こそが、現代のマーケターに求められるスキルです。
AIが情報を取得・評価する「RAG」と「事前学習」の仕組み
LLMO対策を深く理解するためには、AIがどのように情報を学習し、回答を生成しているのかという技術的背景を知る必要があります。特に「事前学習(Pre-training)」と「RAG(Retrieval-Augmented Generation:検索拡張生成)」の2つの仕組みを理解することは、施策の優先順位を決める上で極めて重要です。
事前学習とRAGの基本的な違い
まず「事前学習」とは、AIモデル(GPT-4やGeminiなど)が開発段階で膨大なインターネット上のデータを読み込み、知識として定着させるプロセスです。ここに自社の情報が含まれると、AIは「基礎知識」として自社のことを記憶します。しかし、事前学習にはタイムラグがあり、数ヶ月から数年前の情報で知識が止まっていることも少なくありません。そのため、新製品の情報や最新のトレンドについては、事前学習だけに頼ることはできません。
そこで重要になるのが「RAG」です。
RAGとは、AIがユーザーから質問を受けた瞬間に、インターネット上をリアルタイムで検索し、関連性の高い情報を取得して回答を生成する仕組みです。GoogleのAI OverviewsやPerplexityはこのRAGをベースにしています。2026年現在のLLMO対策の主戦場は、まさにこの「RAG」においていかに自社の情報をAIに見つけてもらい、引用元として採用させるかにあります。実は、この理解こそが、多くの企業が施策の優先順位を誤る原因になっているのです。
AIがRAGで情報を評価する4つのステップ
AIはRAGのプロセスにおいて、以下のステップで情報を評価しています。
第一は「検索と抽出」です。ユーザーの問いに関連する情報をWeb上から複数ピックアップします。この段階で自社のページがクローラーにインデックスされていなければ、以後のプロセスに進むことはできません。robots.txtの設定やサイトの技術的な健全性が重視される理由はここにあります。
第二は「関連性の判定」です。取得した情報が問いに対してどれだけ直接的な答えを持っているかを測定します。ここでは、結論ファーストの構造や、キーワードの自然な出現がモノを言います。
第三は「信頼性のスコアリング」です。その情報のソース(ドメインや著者)が信頼できるかを判定します。SEOで高い評価を得ているサイトは、ここでも有利になるのです。
第四は「要約と統合」です。複数の情報を組み合わせて、矛盾のない回答を作成します。
マーケターが見落としやすいAIの情報評価の本質
ここでマーケターが意識すべきは、AIは「最も詳しい記事」を探しているのではなく、「最も回答に使いやすい(要約しやすい)信頼できる断片」を探しているという点です。どんなに長文で網羅的な記事を書いても、結論が埋もれていたり、構造が複雑だったりすると、AIの抽出プロセスから漏れてしまいます。
また、AIは「一次情報」や「最新の数値データ」を非常に好みます。他のサイトの焼き直しではない、自社独自の調査結果やリアルタイムの価格情報などは、RAGにおける優先順位を劇的に高めます。AIに「新しい事実はこのサイトにある」と認識させること。これが、RAG時代における知識供給型LLMOの核心なのです。
2026年のLLMO対策に必要な二層構造の戦略
2026年のLLMO成功には、事前学習と RAGの両方へのアプローチが必要です。長期的には自社を業界の権威として事前学習に組み込ませ、短期的にはRAGで最新情報を確実に引き出させる。この二層構造の戦略こそが、AIエコシステムにおける確実な地位を保証するのです。
【コンテンツ編】AIに選ばれるための具体的対策5選
生成AIが回答を生成する際、ソースとして選ばれやすいコンテンツには共通のパターンがあります。2026年現在のAIアルゴリズムに最適化された、コンテンツ制作の5つの鉄則を解説します。
対策1:結論ファーストの「逆ピラミッド構造」
AIは情報を抽出する際、冒頭に明確な答えがあるテキストを極めて好みます。特に「〇〇とは、~である」という定義文を記事の冒頭や各見出しの直下に配置することで、AIは迷わずにその部分を引用範囲として特定できます。Webライティングの基本である結論ファーストを、AIのためにさらに徹底することが求められます。
従来のSEOでは、ユーザーの興味を引くために導入部を長めに取ることがありました。しかし、AIはそうした「引き込み」を必要としません。むしろ、最初の一文で核心を伝える力が、AIに選ばれるコンテンツの最大の特徴です。
対策2:独自調査データと「一次情報」の言語化
AIは既存のWeb情報を要約することは得意ですが、新しい事実を「発見」することはできません。そのため、自社で行ったアンケート結果や、特定のプロジェクトでの成功・失敗事例、実験データなど、他社が持っていない「一次情報」を公開することが強力なLLMO対策になります。
2026年、多くのメディアがAIによる自動生成記事で溢れる中、人間によるリアルな体験談や独自の数値データは、AIにとって「引用せざるを得ない貴重なリソース」となります。例えば、「業界別の導入事例」や「ユーザーの満足度調査」など、自社だけが持つデータセットは、AIが「このサイトを参照元として明記する価値がある」と判断する最高の理由になるのです。
対策3:FAQ(質問と回答)形式の導入
ユーザーがAIに問いかける文章(自然言語クエリ)を想定し、それに対する明確な回答をセットで記述するFAQセクションを設けることは、非常に有効です。AIは「問いと答えのペア」を認識しやすく、AI Overviewsなどの強調スニペット的な回答箇所に採用される確率が劇的に向上します。
実際のところ、FAQページを新たに導入した企業の中には、AI回答内での引用率が30%以上向上したというケースも報告されています。なぜなら、AIはこの形式を学習時に数多く目にしており、構造的に理解しやすいため、抽出と処理が容易だからです。
対策4:客観的・フォーマルな文体(Wikipediaスタイル)
意外かもしれませんが、過度に感情的な表現や、装飾の多いカジュアルな文体よりも、Wikipediaのような淡々とした客観的な記述の方がAIには好まれます。AIは情報の「事実性」を重視するため、断定的な表現や、論理的な接続詞を用いたフォーマルな文章の方が、信頼性が高いと判断されやすいためです。
これは、ブランドの個性を失うということではありません。むしろ、専門家が書いた技術文書のような「権威性を備えた文体」こそが、AIの学習パターンと合致しているのです。感情的な修飾よりも、事実と根拠を積み重ねる方が、AIからの評価が高まる傾向が明らかになっています。
対策5:統計・数値データの適切な配置
「多くの人が利用している」という曖昧な表現ではなく、「導入社数5,000社、満足度94.8%」といった具体的な数値を、表やリスト形式で提示してください。AIは構造化された数値をスキャンするのが得意であり、回答の根拠(RTB:Reason To Believe)としてこれらの数値を引用する傾向があります。
特に、第三者調査機関による統計やオープンデータの引用は、AIの信頼性評価を大きく高めます。一社のみの主張ではなく、複数の情報源から導き出された数値であれば、AIは「複数の根拠に基づいている」と判断し、より自信を持って引用するようになるのです。
これら5つの対策は、決して難しいものではありません。しかし、多くの企業はまだ従来のSEOライティングの延長で記事を作成しているため、この基本を徹底するだけで、AIからの引用率は大きく向上します。2026年のコンテンツ制作では、人間の読者とAIの両方を同時に満足させる、この新しい書き方を習慣化することが成功の鍵になるのです。
【テクニカル編】AIクローラーに優遇される技術的対策4選
コンテンツがどれほど優れていても、AIクローラーがその内容を正確に解釈できなければ意味がありません。技術的な側面からAIへのアクセシビリティを高める4つの施策を解説します。
対策1:JSON-LDによる構造化データの実装
Schema.orgに基づいた構造化データの実装は、LLMOの生命線です。特に「Article」「Product」「Organization」「FAQPage」などのプロパティを詳細に記述することで、AIはテキストの断片ではなく「これは何についての情報か」というエンティティ(実体)を正確に把握します。
2026年現在、AIは構造化データから直接情報を抽出する頻度を高めており、セマンティックなマークアップは必須と言えます。例えば、企業のAboutページにOrganizationスキーマを実装すれば、AIは「この会社の創業年」「代表者」「主要事業」といった情報を構造化された形で理解できるようになります。これにより、AIが質問に答える際に、より正確で一貫性のある情報源として自社を参照する可能性が劇的に高まるのです。
対策2:robots.txtによるクローラー最適化
主要なAIモデルのクローラー(OpenAIのGPTBot、GoogleのGoogle-Extended、AnthropicのClaudeBot等)に対し、適切なアクセス許可を与えているか確認してください。著作権保護の観点から全てをブロックする企業も増えていますが、それではAI検索の結果に自社が表示されることはありません。
戦略的に「どのディレクトリをAIに読ませるか」を管理することが重要です。例えば、顧客向けの限定ページや、競合他社への対策として機密情報を含むセクションはブロックしつつ、公開用のナレッジベースやFAQページは許可するといった、きめ細かい設定が可能です。2026年11月現在、大手のAIサービス事業者は公式にこれらのクローラーボットを公開しており、どのエージェントをどう対応するかは、明確な戦略判断が求められます。
対策3:JavaScript依存からの脱却(HTMLへの直書き)
一部のAIクローラーは、依然としてJavaScriptを完全にレンダリングした後のコンテンツを読み取ることが苦手な場合があります。特にモダンなSPA(Single Page Application)で構築されたサイトでは、重要なコンテンツが初期HTMLに含まれていないため、AIがページの本質的な内容を見落とす危険があります。
重要なコンテンツや結論部分は、サーバーサイドでレンダリングするか、HTMLソース内に直接記述されるように設計してください。AIに「生」のテキストを届けることが、確実なインデックスへの近道です。実務的には、コンテンツ管理システム(CMS)のテンプレート設計時点で、「AIが読むべき情報は全てHTMLの初期状態に含める」というルールを定めておくことで、後々のトラブルを防ぐことができます。
対策4:「llms.txt」の試験的導入
2026年に入り、Webサイトのルートディレクトリに「llms.txt」というAI専用の案内ファイルを設置する動きが標準化しつつあります。これはサイトマップのAI版のようなもので、AIが効率的にサイト内の重要ページとその概要を把握するためのメタデータを提供します。
形式としては、各ページのURLとその内容の概要を記述したテキストファイルであり、AIクローラーはこれを優先的に読み込むことで、クロール効率を大幅に向上させることができます。例えば、新製品情報ページや最新のホワイトペーパーが定期的に更新される場合、llms.txtにそれらを明記することで、AIが「このサイトの最新情報はここだ」と認識しやすくなるのです。
現時点で、llms.txtは完全な標準仕様ではありませんが、先行導入することで、AIからの発見可能性を高める先制的な対策として機能します。公式なガイドラインが定まりきらない今だからこそ、試験的に導入し、効果を測定することは、LLMO対策における「ファーストムーバーアドバンテージ」を得るための有効な手段です。
これら4つの技術的対策は、いずれも一度設定すれば継続的な効果が期待できるものばかりです。コンテンツ制作と異なり、実装後のメンテナンス負荷も相対的に低いため、優先度高く取り組むべき施策と言えるでしょう。2026年のLLMO対策において、技術と戦略の両面から支援を受けることは、成功の確度を大きく高めます。
E-E-A-Tの強化がLLMOの成否を分ける理由
2026年のLLMは、情報の正誤を判断する基準として「誰がその情報を発信しているか」という信頼性スコアを極めて重視しています。ここで重要になるのが、SEOでもおなじみの「E-E-A-T(Experience:経験、Expertise:専門性、Authoritativeness:権威性、Trustworthiness:信頼性)」です。
AIは、Web上の情報を集約する際、単に内容が一致しているだけでなく、発信元がその分野の専門家であることを検証しようとします。例えば、医療情報であれば、無名のライターが書いた記事よりも、現役の医師が署名し、かつその医師のプロフィールが構造化データで紐付けられている記事を優先して引用します。これは、AIが学習時に「権威あるソースほど信頼できる」という傾向を強く学んでいるためです。
LLMOにおけるE-E-A-T強化の3つの不可欠な要素
LLMOにおいてE-E-A-Tを強化するためには、以下の3点が不可欠です。
まず「著者のエンティティ化」です。記事の著者が実在し、過去にどのような実績があるかを外部のプラットフォーム(LinkedIn、GitHub、論文データベース等)と紐付けること。AIはこれらの外部参照を通じて、その著者が本当にその分野の専門家であるかを検証しています。単に「著者:田中太郎」と記載するだけでなく、「田中太郎(〇〇大学博士号取得、△△企業CTO、論文発表30本以上)」といった詳細な情報をプロフィールページに集約することで、AIの信頼度スコアは飛躍的に向上します。
次に「組織の権威性証明」です。企業がその業界の団体に所属しているか、受賞歴があるか、メディアでの掲載実績があるかなどの情報をAboutページに集約すること。AIは「この会社は業界で認められている」という事実を確認することで、その会社が発表するコンテンツの信頼性を高く評価するようになります。
そして「外部評価の蓄積」です。他の権威あるサイトから「〇〇の専門家」として言及(サイテーション)されていることが、最も強力な信頼性シグナルになります。
AIは、特定のトピックにおいて「最も頻繁に、かつ肯定的に引用されているソース」を、そのトピックの権威と見なします。つまり、LLMOとは自社を特定の分野における「情報の最終権威」へと育てるプロセスそのものなのです。
E-E-A-T強化のための実務的な施策
実務的には、以下の施策が有効です。一つ目は、社内の専門家を「顔の見える専門家」として育成することです。ホワイトペーパーやブログ記事に著者情報を必ず記載し、その著者のプロフィールページを充実させる。SNSでの発信や業界イベントでの登壇など、複数のタッチポイントで専門家としての実績を積み上げることで、AIが認識する「著者エンティティの強度」が高まります。
二つ目は、デジタルPRの強化です。大手メディアに自社の専門家がコメンテーターとして掲載されたり、業界ニュースで言及されたりすることで、AIにとって「業界で認められた専門家」という確かな根拠が形成されます。
三つ目は、サイテーション獲得の継続的な推進です。自社のデータやノウハウが、他のメディアやレポートで引用されることは、AIにおける権威性スコアを直接的に高めます。
E-E-A-T強化が長期的なLLMO対策の基盤である理由
E-E-A-Tの強化には即効性がありません。しかし、AIが情報源を選定する際に、これほど重く評価される要素は他にないというのが現実です。2026年のLLMO対策において、「短期的なテクニック」ではなく、「長期的なブランド構築」にこそ投資する企業が、AIによる継続的な推奨を獲得することになるのです。
言及(メンション)を獲得するための外部施策とPR戦略
LLMOは自社サイト内の最適化だけで完結するものではありません。AIはWeb全体を学習しているため、自社サイトの外で「自社がどう語られているか」が、AIの回答に決定的な影響を与えます。
2026年のマーケティングにおいて、PR(広報)とLLMOは密接に融合しています。AIがある製品を「おすすめ」として紹介する際、その根拠の多くは第三者メディアのレビュー記事、ニュースサイトの報道、あるいはWikipediaの記述に基づいています。つまり、自社が「業界で注目される存在」であることを、外部のメディアに証言してもらうことが、AIの推奨率を直結的に高める最も確実な手段なのです。
効果的な外部施策としては、以下の戦略が挙げられます。
デジタルPRの強化とニュースサイトでの言及
デジタルPRの強化です。ニュース性の高いプレスリリースを配信し、大手ニュースサイトに転載されることで、AIに「今、注目されている事実」として認識させる。このプロセスは、従来のSEOにおけるバックリンク獲得と似ていますが、LLMO文脈では「信頼できるニュースソースでの言及」という形になります。AIは主流メディアでの報道を、その企業や製品の信頼性を示す最高の根拠と見なすため、プレスリリース配信は優先度高い施策です。
比較・レビューサイトでの露出戦略
比較・レビューサイトへの露出も重要です。第三者が運営する比較サイトで自社製品が高い評価を受けるよう働きかけること。AIは「A社とB社の違いは?」という質問に対し、これらの比較記事を統合して回答を作ります。その際、複数の比較サイトで一貫して高く評価されている製品は、AIにとって「業界コンセンサスとしておすすめされている」という信号になるのです。
Wikipediaの整備と情報提供
Wikipediaの整備も見逃せません。ガイドラインに抵触しない範囲で、自社や関連する専門用語の情報をWikipediaに提供すること。AIにとってWikipediaは依然として最も信頼性の高い学習ソースの一つです。ただし、直接的な営業目的での編集は禁止されているため、業界用語の定義や歴史的背景など、社会全体にとって有用な情報として貢献することが前提になります。
さらに実務的には、以下のアプローチが有効です。
メディアリレーションの構築
まず「メディアリレーション」の強化です。業界を代表するメディアやジャーナリストとの関係を構築し、定期的に自社の専門家をコメンテーターとして提供する。「〇〇について業界専門家の〇〇氏に聞きました」という形式での記事掲載は、自社のE-E-A-Tを外部メディアから証明してもらう最高の方法です。
業界データの先行提供
次に「業界データの公開」です。自社が保有するユニークな業界調査データやトレンドレポートを、メディアに先行提供すること。メディアはオリジナルデータを欲しており、それを独占提供することで、自社が「その業界の信頼できる情報源」として複数のニュース記事に引用される可能性が高まります。
SNSでの発信と権威性構築
そして「SNSでの発信」です。LinkedInなどのプロフェッショナルネットワークで、自社の経営陣や専門家が業界インサイトを定期的に発信すること。AIはSNS上での「いいね」や「シェア」といったシグナルも学習の対象にしており、広くフォローされている専門家の発言は、その分野での権威性を示す根拠になります。
自社サイトが「1」の情報を発信し、外部メディアがそれを「10」に増幅させる。その増幅された「10」の声をAIが拾い上げる。このエコシステムを理解したPR戦略こそが、LLMOを成功させる鍵となります。
2026年においては、SEOの時代のように「自社で全てを完結させる」という考え方は通用しません。むしろ、業界全体での「自社の位置づけ」をいかに確立するかが、AIによる推奨獲得の最短経路です。予算の割き方も、従来のSEOツール導入よりも、戦略的なPR活動に重点を置く企業ほど、LLMO対策で成功する傾向が明らかになっています。
クリニックやBtoB企業が取り組むべき業界別LLMOのポイント
LLMO対策は業界によって、その重点の置き方が大きく異なります。医療機関や士業、BtoB企業など、専門性が高く、かつユーザーの意思決定が重い業界ほど、LLMO戦略の効果は顕著に現れます。
医療機関における広告ガイドラインとAI対策の両立
医療機関(クリニック・病院)の場合、最大の課題は「医療広告ガイドラインとAI対策の両立」です。医療広告は厳しく制限されており、誇大表示は許されません。しかし、これはAI対策にとって有利に働きます。AIは「慎重で正確な情報」を高く評価するからです。
具体的には、以下の施策が有効です。医師のプロフィール充実では、資格、学位、論文実績、所属学会などを構造化データ(Schema.org)で明記すること。AIは「この医師は〇〇分野の専門家である」という事実を自動認識できるようになり、その医師が執筆した記事の信頼度が飛躍的に向上します。次に症例・実績の客観的公開です。患者数、治療成功率、学会発表実績などの定量的なデータをAIが解釈しやすい形式で提示すること。これらは医療広告ガイドラインでも認められている範囲が多く、同時にAIの評価も高める投資効率の良い施策です。
さらにQ&Aの強化が重要です。「〇〇治療は保険適用されますか」「治療期間はどのくらいですか」といった患者が実際に抱く疑問に対し、医師が直接答えるFAQページを設置すること。これはAI Overviewsに引用される可能性を劇的に高めます。
BtoB企業における比較文脈での露出戦略
BtoB企業の場合、異なるアプローチが求められます。最大の特徴は「比較文脈での露出」が極めて重要だということです。営業ツール、マーケティングオートメーション、クラウドストレージなど、選定肢が複数ある領域では、「〇〇と△△ツールの違いは?」という比較質問がAIに頻繁に投げかけられます。
ここで自社製品が「おすすめ候補」として言及されるには、比較サイトや業界レポートでの高い評価が不可欠です。つまり、デジタルPRやアナリストレポートへの掲載、ユーザーコミュニティでの好評判といった、第三者による「推奨」の蓄積が、AI回答内での言及確率を直結的に左右するのです。
実務的には、以下の施策の組み合わせが有効です。まず、業界アナリスト(ガートナー、フォレスター等)との関係構築。これらのレポートにおける位置づけは、AIが「市場で評価されている製品」と判断する最高の根拠になります。次に、顧客導入事例の充実。「〇〇業界の△△社が□□により売上30%向上」といった具体的な成功事例は、AIが製品の価値を理解し、推奨する際の説得力を大きく高めます。そして、業界イベント・セミナーでの登壇。ウェビナーやカンファレンスでの発表は、メディア報道につながり、AIの学習データとしても取り込まれやすくなります。
士業における専門性の透明化
士業(弁護士、税理士等)の場合、専門性の透明化がすべてを決めます。AIは「この専門家は〇〇分野に精通している」という情報を、論文、著書、講演実績、メディア掲載などから自動抽出します。これらを整備することで、AIは「相続税について質問された時は、この税理士事務所の記事を参照すべき」と判断するようになるのです。
既存活動とLLMO対策のシームレスな統合
重要なのは、これらの施策が決して業界固有の特殊な対応ではなく、むしろ「その業界において、すでに信頼を得ている企業が行っていること」をAIが認識しやすくするだけ、という点です。言い換えれば、既存の営業・マーケティング活動とLLMO対策がシームレスに統合されることで、初めて効率的な成果が生まれるのです。
2026年においては、業界特性を無視した汎用的なLLMO対策は機能しません。むしろ、「自社の業界では、AIがどんな判断基準を使っているのか」を正確に把握し、その判断基準に最適化した施策を打つ企業ほど、AIによる継続的な推奨を獲得することになるのです。
LLMOの効果測定とKPI設定の新しい基準
LLMOの効果測定は、従来のSEO評価よりも格段に複雑です。なぜなら、AIの回答内で自社が言及されても、それが直接アクセス解析に反映されないケースが大半だからです。この計測の難しさを正しく理解し、適切なKPIを設定することが、LLMO戦略の継続性を確保する上で不可欠です。
従来のSEOとLLMO時代における指標の違い
従来のSEOでは「検索順位」と「セッション数」がすべてでした。しかし、LLMO時代には異なる指標体系が必要です。
AI回答内での自社言及の検出
最初のステップは「AI回答内での自社言及の検出」です。これは手作業による定点観測が基本になります。ChatGPT、Gemini、Perplexity、Claude等、主要なAIプラットフォームに対し、業界に関連した想定クエリ(「〇〇とは」「おすすめの□□」など)を定期的に投げかけ、回答内に自社名や製品名が登場するかを記録する。この作業は月1回程度の頻度で継続することで、言及率の推移を可視化できます。
ただし、注意点があります。AIは「温度パラメータ」(回答のランダム性を制御する設定)によって、同じ質問に対して異なる回答を生成することがあります。そのため、各クエリに対して複数回(最低でも3回、理想的には10回以上)テストを実施し、統計的な言及率を算出することが重要です。例えば「〇〇ツール おすすめ」というクエリに対し10回質問を投げかけて、そのうち7回自社製品が言及されれば、言及率は70%という評価になります。
指名検索数の推移による測定
次に重要なKPIは「指名検索数の推移」です。AIの回答で自社が言及されると、ユーザーはその後、自社名を指名検索するようになります。つまり、AIからの言及がユーザーのブランド認知につながったかどうかを、Google検索のオーガニック流入で測定できるということです。GA4では、特定のブランドキーワード(自社名、自社製品名)でのセッション数の増減をモニタリングすることで、LLMO施策の間接的な成果を把握できます。
AI経由の流入計測
AI経由の直接的な流入を計測する場合、GA4の参照元フィルタリングが有効です。ChatGPTやGemini等からのアクセスは、参照元が「chatgpt.com」「google.com/search」といった形式で記録されることがあります。これらをカスタムセグメントで抽出し、AI経由の流入セッションを分離することで、AI検索からの直接効果を定量化できます。
LLMO施策の真の効果を測定する課題と対策
しかし、ここに大きな落とし穴があります。AIの回答内で言及されたとしても、ユーザーが「その場で満足して」クリックしないケースが多いからです。つまり、GA4のデータだけではLLMO施策の真の効果が見えません。
そこで推奨される追加的な計測手法が「認知経路アンケート」です。定期的にサイト訪問者に対し「このサイトをどうやって知りましたか?」という問いを投げかけ、「AIの回答で見かけた」という回答を集計する。シンプルですが、これ以上に正確なLLMO効果の計測方法は存在しません。
その他の重要な指標
その他の指標としては、以下のものが推奨されます。
- 「AI推奨率」は、想定クエリに対するAIの回答内での言及有無を、複数のAIプラットフォーム横断で集計したもの。自社がどの程度「AIに推奨される存在」か、相対的な競争優位性を把握するのに役立ちます。
- 「第一推奨率」は、AIの最初の提案や最優先の選択肢として言及される比率。単なる言及だけでなく、「最も推奨されているのか」という階層まで測定することで、ブランド力の実質的な向上を評価できます。
- 「外部サイテーション数」も重要です。Wikipedia、業界レポート、ニュースサイト等での自社言及数をツール(SERankingやAhrefsの一部機能等)で定期計測し、その推移を追跡する。この指標は、AIの事前学習やRAGデータソースとしての位置づけが高まっていることを示す信号になります。
LLMO効果スコアの統合と中長期的な計測体制の構築
最後に、これらの指標を統合した「LLMO効果スコア」を四半期ごとに算出することで、経営層への報告や、施策の優先順位決定が容易になります。ただし、LLMO対策は中長期的な投資であり、短期的な変動に一喜一憂しないことが肝要です。3ヶ月単位での改善を期待するのではなく、6ヶ月から1年単位での定着と効果の可視化を前提に、計測体制を整えることが現実的です。
LLMO対策における注意点とよくある誤解
LLMO対策の実施を急ぐあまり、多くの企業が陥りやすい誤解や落とし穴が存在します。正しい理解を欠いたまま施策を打つと、リソースを浪費し、かえってブランド価値を傷つける可能性さえあります。ここでは、LLMO推進の際に最も注意すべき点をまとめます。
キーワード詰め込みの落とし穴
SEOの時代、ユーザーが検索するキーワードを記事に散りばめることは当たり前でした。しかし、LLMOではこの手法は逆効果になります。AIは「キーワードの出現頻度」ではなく「エンティティの明確性」を評価します。同じ概念を何度も繰り返す代わりに、最初に結論を提示し、その後は関連情報を整理して提供する方が、AIからの評価が高まります。実際、キーワード詰め込みが検出された記事はAIに「作為的な情報操作」と判断され、引用を避けられるケースさえあります。
技術的対応だけでは不十分
2026年のトレンドとして、llms.txtやLLMO専用の設定に注目が集まっています。しかし、これらは補助的なツールに過ぎません。それらを設置しても、サイトの基本的な信頼性やコンテンツの質が低ければ、AIは自社を参照源として採用しません。むしろ、E-E-A-Tの強化やコンテンツの本質的な改善なしに、技術的な小手先の対応だけを進める企業ほど、失望することになるでしょう。
新規記事の大量作成より既存ページの強化
LLMO対策として新しいブログ記事を次々と作成する企業が多いですが、これは効率的ではありません。むしろ、既存の重要ページに対し「AIが引用したくなる要素」を追加する方が、はるかに費用対効果が高いのです。構造化データの追加、独自データの埋め込み、専門家による監修の明示といった改善は、新規記事作成より手間が少なく、かつ既に検索上位にあるページに施すため、AIの目に留まりやすいのです。
誤情報・ハルシネーション対策の必要性
AIは時に、学習データに基づいて事実ではない情報を信じ込み、それを回答として出力することがあります。これを「ハルシネーション」と呼びます。自社の情報がAIに引用されるようになると、誤った情報も増幅される可能性があります。そのため、サイトに掲載する情報は常に正確性をチェックし、定期的に更新する必要があります。特に数値やデータについては、出典を明示し、信頼性を担保することが重要です。
AI最適化とユーザー体験のバランス
AI向けの最適化を進めるあまり、人間の読者にとって読みやすいサイトになっていないケースがあります。例えば、「結論ファースト」を過度に推し進めると、記事が退屈で、背景知識がない読者には理解しにくくなる可能性があります。大切なのは「AIと人間の両方を満足させる」という視点です。構造化データやマークアップを増やすことは有効ですが、ユーザーの利便性を損なわない範囲で行うことが前提です。
SEOへの投資を継続すること
LLMO対策の重要性が高まっているからといって、従来のSEO施策を軽視してはいけません。検索エンジン経由の流入は依然として重要であり、SEOで獲得した上位表示こそが、AIによる引用可能性を高める土台になるのです。むしろ、SEOとLLMOは相互補完的な関係にあり、両方に並行して投資する必要があります。予算配分の際は、SEOを全体の60~70%、LLMOを30~40%といったバランスで進めることが現実的です。
長期的な視点での効果測定
LLMO対策の成果は、SEO以上に長期的な視点が必要です。事前学習への組み込みだけで見ても、発表から効果が顕在化するまで数ヶ月から1年要することもあります。短期的な数字で施策の成否を判断し、すぐに方針を変更してしまうと、本来の効果が出ないまま投資が打ち切られるリスクがあります。最低でも6ヶ月、理想的には1年単位での効果測定を前提に、継続的に取り組むことが重要です。
まとめ:生成AI時代に「選ばれ続ける」ためのWeb戦略
2026年11月の今、Web検索の風景は完全に変わりました。かつての「キーワード検索→リンククリック→サイト訪問」という単線的なカスタマージャーニーは過去のものです。今、ユーザーはAIに問いかけ、その場で回答を得る。その過程で自社のブランドが言及されるかどうかが、企業のマーケティング成功を左右する時代に突入しているのです。
しかし、ここで重要な気づきがあります。LLMO対策は、決して従来のマーケティングの破壊ではなく、その「進化」に他なりません。
本記事を通じて解説してきた5つのコンテンツ対策、4つの技術対策、E-E-A-T強化、外部PR戦略といった施策は、すべて「ユーザーと企業の両者にとって価値ある状態を作る」という本質に帰結しています。AIに引用されやすいコンテンツとは、結局のところ、人間の読者にとっても信頼でき、専門性が高く、正確な情報なのです。検索エンジンのアルゴリズムがどう変わろうとも、この本質は変わりません。
2027年、2028年への企業の進むべき道
2027年、2028年へと進む中で、企業が取るべき道は明確です。
- SEOへの基本的な投資は続けること。検索エンジン経由の流入は依然として重要であり、SEOで培った「高品質なコンテンツ」というアセットは、LLMO対策の最強の土台です。
- 自社の専門性と信頼性を、あらゆるチャネルで一貫して発信すること。自社サイト、SNS、メディア出演、業界イベント、プレスリリース、論文発表といった複数のタッチポイントにおいて、「この企業は〇〇の専門家である」というメッセージを繰り返し発信することで、AIの学習データにも、ユーザーの認識にも、その評価が刻み込まれます。
- 短期的な数字に惑わされないこと。LLMO対策の成果は中長期で現れます。AI Overviewsへの掲載やAI推奨率の向上は、6ヶ月から1年単位での継続的な取り組みが実を結ぶものです。
最後に、もっとも大切なのはこれです。AI時代に「選ばれ続ける企業」になるとは、決して特別な技法やテクニックを駆使することではなく、ユーザーと社会に対して、継続的に価値を提供し続ける姿勢そのものなのです。AIは、単なるツールです。その背後にあるのは、常に人間です。
今、企業が準備すべきこと
今、あなたの企業が準備すべきことは、技術的なLLMO最適化ではなく、「AIにも人間にも選ばれ続ける企業体質」へのシフトです。本記事で示した9つの具体的施策を、自社の現状と業界特性に合わせて取捨選択し、実装する。その過程で、必要に応じて外部のコンサルティングサポートを活用する。そうして一歩ずつ進めることが、生成AI時代における確実な勝利の道です。
2026年はAIエコシステムの構築を急ぐ時期ですが、焦りは禁物です。むしろ、「5年後、自社がユーザーとAIの両者から最も信頼される情報源であり続けるには、今何をすべきか」という中長期的な問いを常に念頭に置いて、施策を推進してください。その時間軸こそが、AI時代におけるマーケティングの羅針盤になるのです。